Was ist eine KI-optimierte Website?
Eine KI-optimierte Website ist eine für Menschen entwickelte Website, deren wichtige Informationen in klassischer wie generativer Suche zugänglich, verständlich, überprüfbar, konsistent und messbar sind. Jede wichtige Tatsache hat eine verantwortliche Quelle, jede priorisierte Seite einen klaren Zweck und jede Launch-Entscheidung einen reproduzierbaren Nachweis.
Sie ist keine zweite Website für Bots. Sie hängt weder von einem „KI-Schema“ oder einer KI-Sitemap noch von einer universellen Wortzahl oder einer Datei mit Zitiergarantie ab. Googles Leitfaden für generative KI-Funktionen stellt klar, dass die bewährten Search-Grundlagen gelten und weder spezielles KI-Markup noch eine maschinenorientierte Aufbereitung nötig sind.
Der praktische Standard lautet:
Eine Seite sollte für Menschen funktionieren, den technischen Abrufweg überstehen, überprüfbare Aussagen enthalten, öffentliche Fakten synchron halten und nach dem Release Nachweise erzeugen.
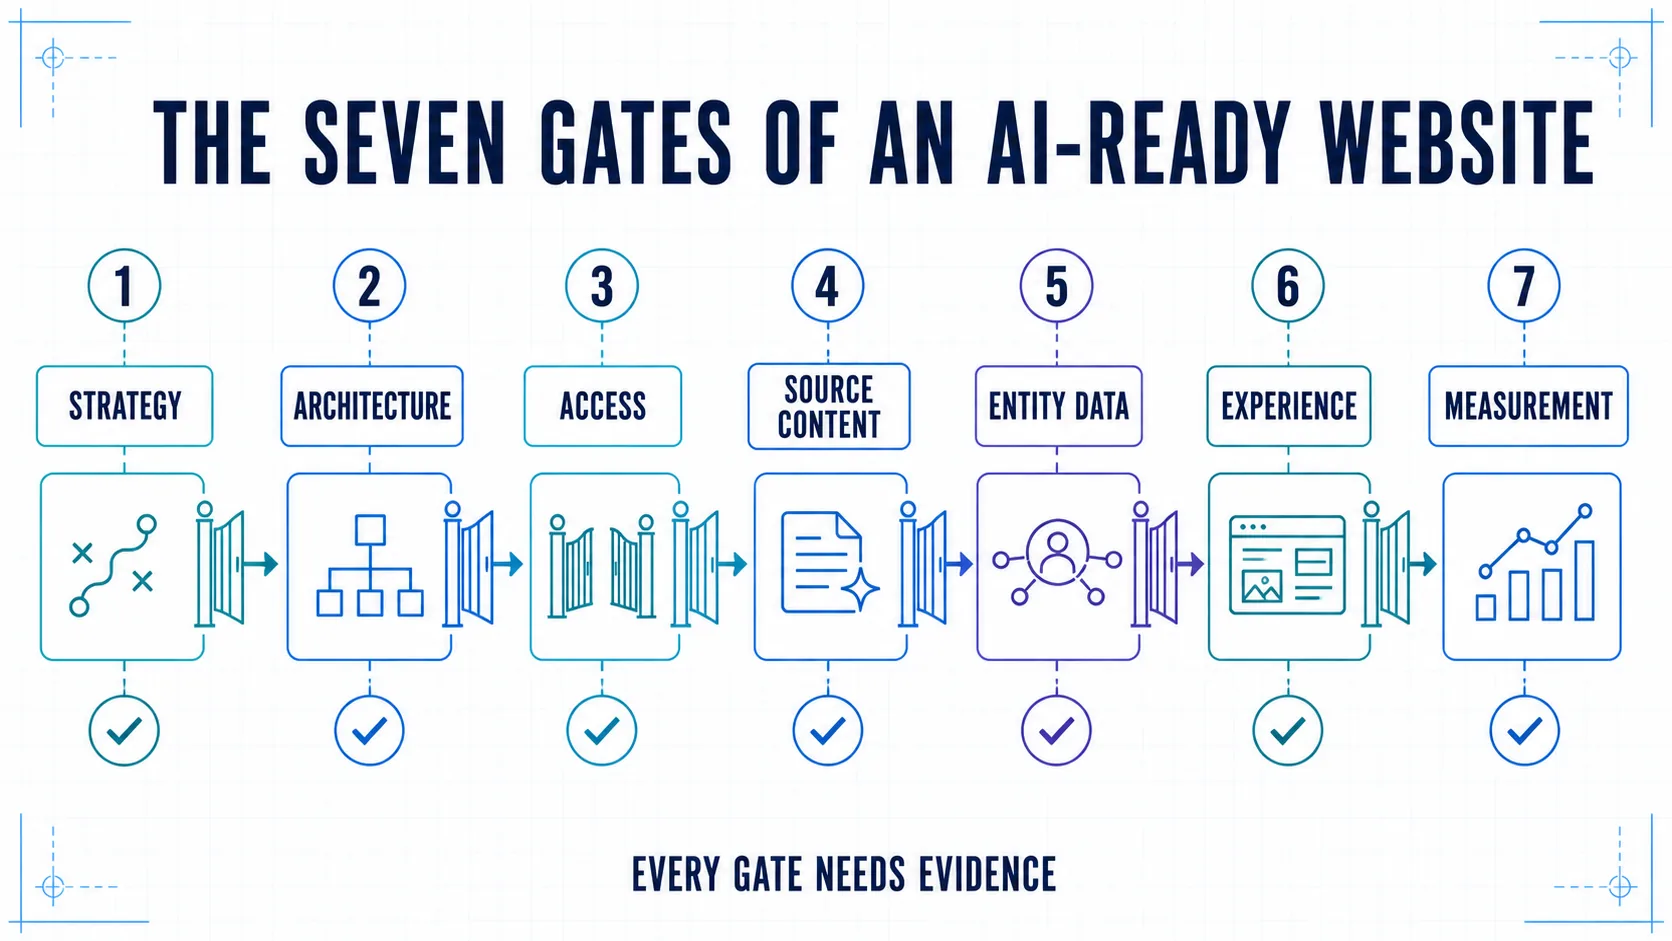
Diese Checkliste übersetzt den Standard in sieben Launch-Gates.
So nutzen Sie diese Checkliste
Behandeln Sie die Checkboxen nicht als einmaligen Score. Erfassen Sie für jeden wesentlichen Punkt vier Felder:
- Verantwortung: die für die Entscheidung zuständige Person.
- Bestanden-Kriterium: der beobachtbare Zustand, der als erledigt gilt.
- Nachweis: URL, Response-Capture, Test, Log-Auszug, Quelle oder Screenshot.
- Retest: Datum oder Release-Ereignis für die nächste Prüfung.
„Crawler-Zugriff konfiguriert“ ist kein Bestanden-Kriterium. „OAI-SearchBot erhielt in Produktion einen 200, die Hauptantwort war im gerenderten HTML vorhanden und der Request erschien am 06.09.2026 in den Edge-Logs“ ist eines.
Launch-Blocker im Überblick
| Gate | Nicht launchen, wenn … | Mindestnachweis |
|---|---|---|
| Strategie | Verantwortung oder Geschäftsentscheidung fehlen | freigegebener Scope und Owner-Matrix |
| Architektur | eine priorisierte Intention kein kanonisches Ziel hat | Route- und Redirect-Crawl |
| Zugriff | Produktion blockiert, fehlschlägt, falsch kanonisiert oder leeren Hauptinhalt liefert | Raw Response, gerenderte Seite und Log |
| Quelleninhalte | folgenreiche Aussagen unbelegt oder irreführend sind | geprüftes Claim-Register |
| Entitätsdaten | sichtbare Fakten, JSON-LD und Feeds widersprüchlich sind | Vergleich der Oberflächen |
| Erlebnis | die Hauptaufgabe unter repräsentativen Mobilbedingungen scheitert | Felddaten oder Release-Test |
| Messung | Baseline, Release-Marker oder Conversion-Prüfung fehlen | gespeicherter Report und Event-Test |
Gate 1: Strategie und Betriebsmodell definieren
„Die Website für KI optimieren“ ist kein Build-Briefing. Beginnen Sie mit den Entscheidungen, bei denen die Website echten Kunden helfen soll.
- [ ] Definieren Sie Zielgruppen, Märkte, Sprachen, Produkte und Kaufphasen.
- [ ] Listen Sie die geschäftlichen Fragen auf: Kategorieauswahl, Vergleich, Implementierung, Risiko, Preis, Kompatibilität oder Anbieterprüfung.
- [ ] Wählen Sie priorisierte Produkt-, Leistungs- und Redaktionsseiten für den Launch.
- [ ] Bilden Sie Prompt-Familien für diese Fragen; Keywords bleiben ein Input, nicht das ganze Modell.
- [ ] Bestimmen Sie den maßgeblichen internen Datensatz für Produktfakten, Preise, Verfügbarkeit, Richtlinien, Personen, Standorte und Nachweise.
- [ ] Benennen Sie Verantwortliche für Architektur, Inhalte, Zugriff, Entitätsdaten, Analytics, Datenschutz, Sicherheit und Übersetzungen.
- [ ] Definieren Sie Korrektur- und Eskalationswege für falsche oder veraltete Informationen.
- [ ] Trennen Sie Erfolgsmetriken für Search-Sichtbarkeit, Erwähnungen, eigene Zitate, Referral Visits, qualifizierte Conversions und Umsatz.
- [ ] Lehnen Sie Garantien für Rankings, Zitate oder Empfehlungen in Drittsystemen ab.
Zuerst das Entscheidungsprotokoll, dann das Backlog
Dokumentieren Sie, warum das Projekt existiert, was es ausschließt und welche Ergebnisse einen weiteren Release rechtfertigen. So wird „KI-Optimierung“ nicht zur unbegrenzten Sammlung spekulativer Aufgaben.
Ein gutes Ziel lautet beispielsweise: „Unsere fünf priorisierten Serviceentscheidungen sollen aus gepflegten Primärnachweisen auf Deutsch und Englisch beantwortbar sein. Wir prüfen den Zugriff auf den ausgewählten Plattformen und messen qualifizierte Nachfrage pro Landingpage.“ Das ist belastbarer als „in jede KI-Antwort gelangen“.
Gate 1 ist bestanden, wenn: das Team Seiten, Fragen, Quellen der Wahrheit, Verantwortliche, Metriken und Nicht-Ziele benennen kann.
Gate 2: Architektur und Faktenmodell entwerfen
Die Informationsarchitektur gibt jeder eigenständigen Intention ein stabiles Ziel und macht Beziehungen zwischen Seiten verständlich.
URL- und Navigationscheckliste
- [ ] Geben Sie jeder relevanten Intention eine kanonische URL.
- [ ] Erstellen Sie Hubs für große Themen und Vertiefungsseiten für Definitionen, Vergleiche, Methoden, Risiken, Implementierung und Entscheidungen.
- [ ] Verwenden Sie verständliche Navigation und kontextuelle interne Links.
- [ ] Halten Sie priorisierte Seiten über eine sinnvolle Zahl an Klicks erreichbar.
- [ ] Vermeiden Sie fast identische Seiten nur für minimale Keyword- oder Prompt-Variationen.
- [ ] Dokumentieren Sie Regeln für Kleinschreibung, abschließende Slashes, Parameter, Redirects, Pagination und eingestellte Inhalte.
- [ ] Definieren Sie das Verhalten beim Zusammenführen, Umbenennen oder Entfernen von Produkten, Leistungen, Standorten und Artikeln.
- [ ] Lassen Sie Breadcrumbs und XML-Sitemaps die beabsichtigte Hierarchie abbilden.
Fakten einmal modellieren
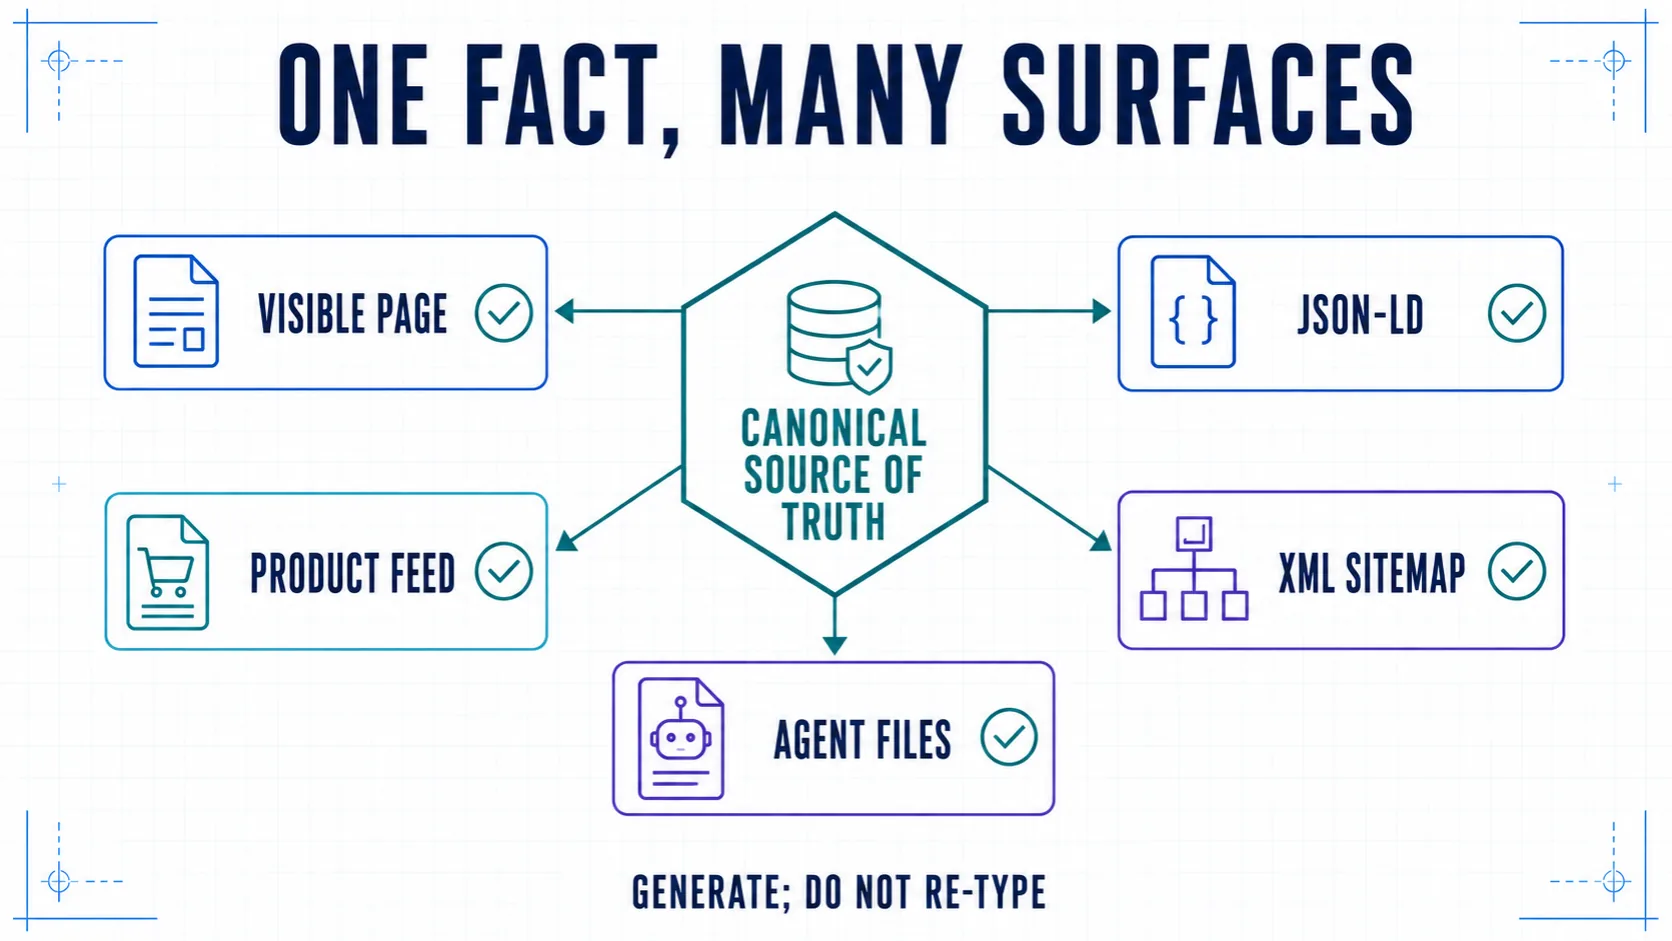
Sichtbare Seite, JSON-LD, Produktfeed, Sitemap und optionale Agenten-Datei sollten keine fünf separat gepflegten Datensätze sein. Sie sollten aus gepflegten Daten und Inhalten entstehen.
- [ ] Definieren Sie kanonische Felder für Organisation, Autor, Produkt, Leistung, Standort, Angebot, Richtlinie und Artikel.
- [ ] Geben Sie stabilen Entitäten dauerhafte Kennungen und URLs.
- [ ] Speichern Sie Daten mit eindeutiger Bedeutung: veröffentlicht, substanziell geändert, geprüft, verfügbar oder gültig bis.
- [ ] Erzeugen Sie wiederholte Fakten nach Möglichkeit aus demselben Datensatz.
- [ ] Trennen Sie redaktionelle Einordnung von Produktfakten.
- [ ] Validieren Sie unmögliche oder widersprüchliche Zustände.
- [ ] Geben Sie volatilen Feldern einen Owner und Aktualisierungsrhythmus.
Das unspektakulärste KI-Feature kann das nützlichste sein: Ein Preis wird an genau einer Stelle geändert. Die Synchronisierung eines langweiligen Fakts über Seite, strukturierte Daten und Feed verhindert einen viel interessanteren öffentlichen Widerspruch.
Gate 2 ist bestanden, wenn: jede priorisierte Intention eine kanonische Route und jeder wichtige Fakt einen verantwortlichen Ursprung hat.
Gate 3: Zugriff, Indexierung, Rendering und Richtlinien belegen
Zugriff ist eine Kette. Eine korrekte robots.txt-Regel überstimmt weder CDN-Challenge oder WAF-Block noch Anwendungsfehler, Login-Wand, Client-Rendering-Problem oder falschen Canonical.
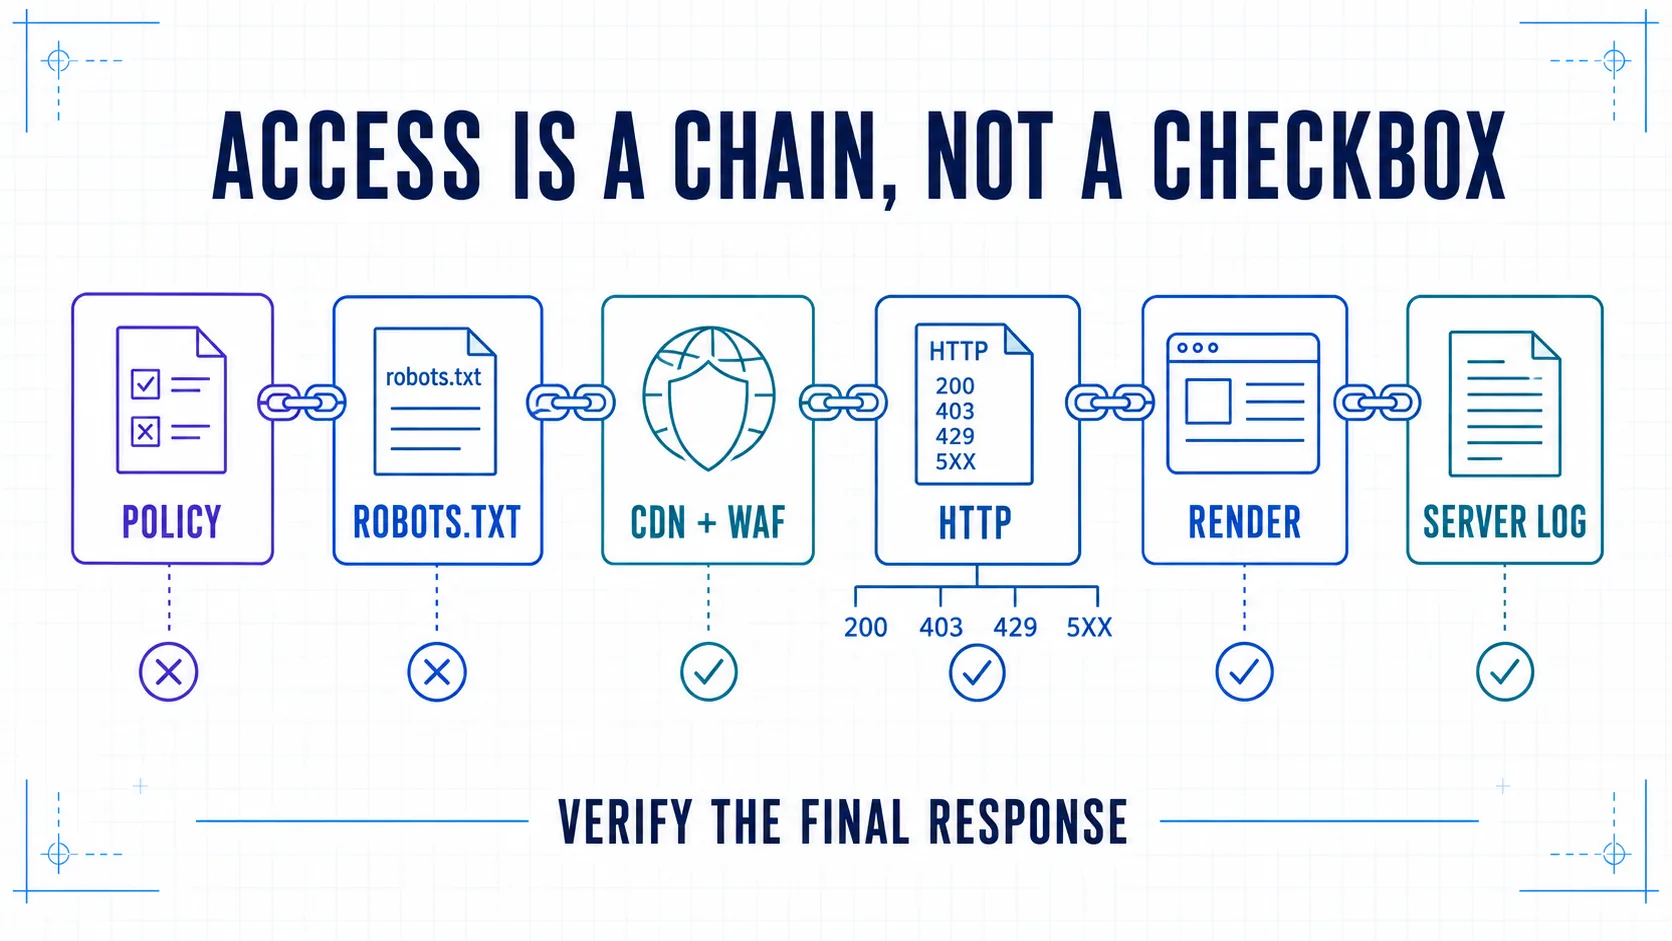
Crawl- und Indexierungsregeln
- [ ] Priorisierte Routen liefern in Produktion direkt einen
200. - [ ] Redirects sind beabsichtigt, endlich und führen zur finalen kanonischen URL.
- [ ] Canonicals zeigen auf erfolgreiche, indexierbare URLs.
- [ ]
robots.txt, Meta Robots,X-Robots-Tag, Authentifizierung und Search-Steuerung entsprechen der freigegebenen Richtlinie. - [ ] XML-Sitemaps enthalten nur absolute, kanonische, indexierbare URLs und korrekte Änderungsdaten.
- [ ] Interne Links nutzen finale URLs statt Redirect-Versionen.
- [ ] Staging bleibt geschützt, ohne Regeln in die Produktion zu übernehmen.
- [ ] Fehler-, Entfernt- und Leerzustände liefern den korrekten HTTP-Status.
- [ ] CDN, WAF, Rate Limits und Bot Management widersprechen dem freigegebenen Zugriff nicht.
- [ ] Server- und Edge-Logs zeigen Status, Pfad, Zeit und Response-Klasse des Crawlers.
Google sagt, dass Seiten indexiert und für Snippets geeignet sein müssen, um in den generativen Search-Funktionen zu erscheinen. Die Anforderungen zu erfüllen garantiert weder Crawling noch Indexierung oder Auswahl. Nutzen Sie URL Inspection und Search-Console-Nachweise; eine eingereichte Sitemap ist kein Inklusionsnachweis.
Die wichtige Antwort zuverlässig rendern
- [ ] H1, Hauptantwort, Text, relevante Links, Canonical, Autor, Daten und passendes JSON-LD stehen im serverseitig gerenderten oder zuverlässig vorgerenderten HTML.
- [ ] Kritische Informationen erfordern weder Klick noch Filter, Suche, Consent-Annahme oder Login.
- [ ] Client-Hydration ersetzt korrekte Metadaten nicht durch veraltete Defaults.
- [ ] Links sind gewöhnliche crawlbare Anker mit echten Zielen.
- [ ] Lazy Loading versteckt weder Haupttext noch Leitmedium.
- [ ] Raw und Rendered HTML werden je priorisiertem Template verglichen.
- [ ] JavaScript-Fehler und fehlgeschlagene API-Requests entfernen den Hauptinhalt nicht.
Google kann JavaScript rendern. Der JavaScript-SEO-Leitfaden empfiehlt dennoch auffindbare Inhalte und Links sowie korrekte Statuscodes und Canonicals. Server- oder Static-Ausgabe reduziert Fehlerstellen für wichtige öffentliche Informationen.
Bot-Zwecke trennen
- [ ] Entscheiden Sie separat über Suchentdeckung, nutzerinitiierte Abrufe und Modelltraining.
- [ ] Prüfen Sie Crawler-Namen und IP-Hinweise in aktueller Primärdokumentation.
- [ ] Testen Sie nach Änderungen die reale Produktionsantwort.
- [ ] Datieren Sie die Entscheidung und beteiligen Sie bei Bedarf Recht, Datenschutz, Lizenzierung und Sicherheit.
OpenAI dokumentiert OAI-SearchBot für ChatGPT Search, GPTBot für mögliches Training und ChatGPT-User für nutzerinitiierte Requests. Perplexity trennt Such-Crawler und nutzerinitiierte Fetcher ebenfalls. Namen und Verhalten können sich ändern; kopieren Sie keine undatierte allgemeine Bot-Liste.
Spezialdateien als optionale Oberfläche behandeln
- [ ] Nutzen Sie die Standard-XML-Sitemap als kanonische Discovery-Datei.
- [ ] Behandeln Sie
llms.txtals optionalen Vorschlag für Agenten, die sie gezielt abrufen. - [ ] Halten Sie Agenten-Dateien sachlich, kanonisch, öffentlich und gepflegt.
- [ ] Stellen Sie
llms.txt, „KI-Sitemaps“ oder KI-Schema nicht als Google-Rankinganforderung dar. - [ ] Lassen Sie experimentelle Dateien keine HTML-, Canonical-, Zugriffs- oder Quellenkorrektur verzögern.
Die `llms.txt`-Spezifikation bezeichnet sich selbst als Vorschlag. Laut Google ist für generative Search-Funktionen weder eine neue maschinenlesbare KI-Datei noch spezielles Markup nötig.
Gate 3 ist bestanden, wenn: Richtlinie, Edge-Zustellung, HTTP-Status, gerenderter Inhalt, Canonical-Auswahl und Logs dieselbe Geschichte erzählen.
Gate 4: Quellenbasierte Inhalte statt Prompt-Füllmaterial bauen
Eine zitierwürdige Seite löst eine echte Unsicherheit und erlaubt die Prüfung der wichtigen Aussagen. Sie muss nicht jede künftige Prompt-Formulierung vorhersagen.
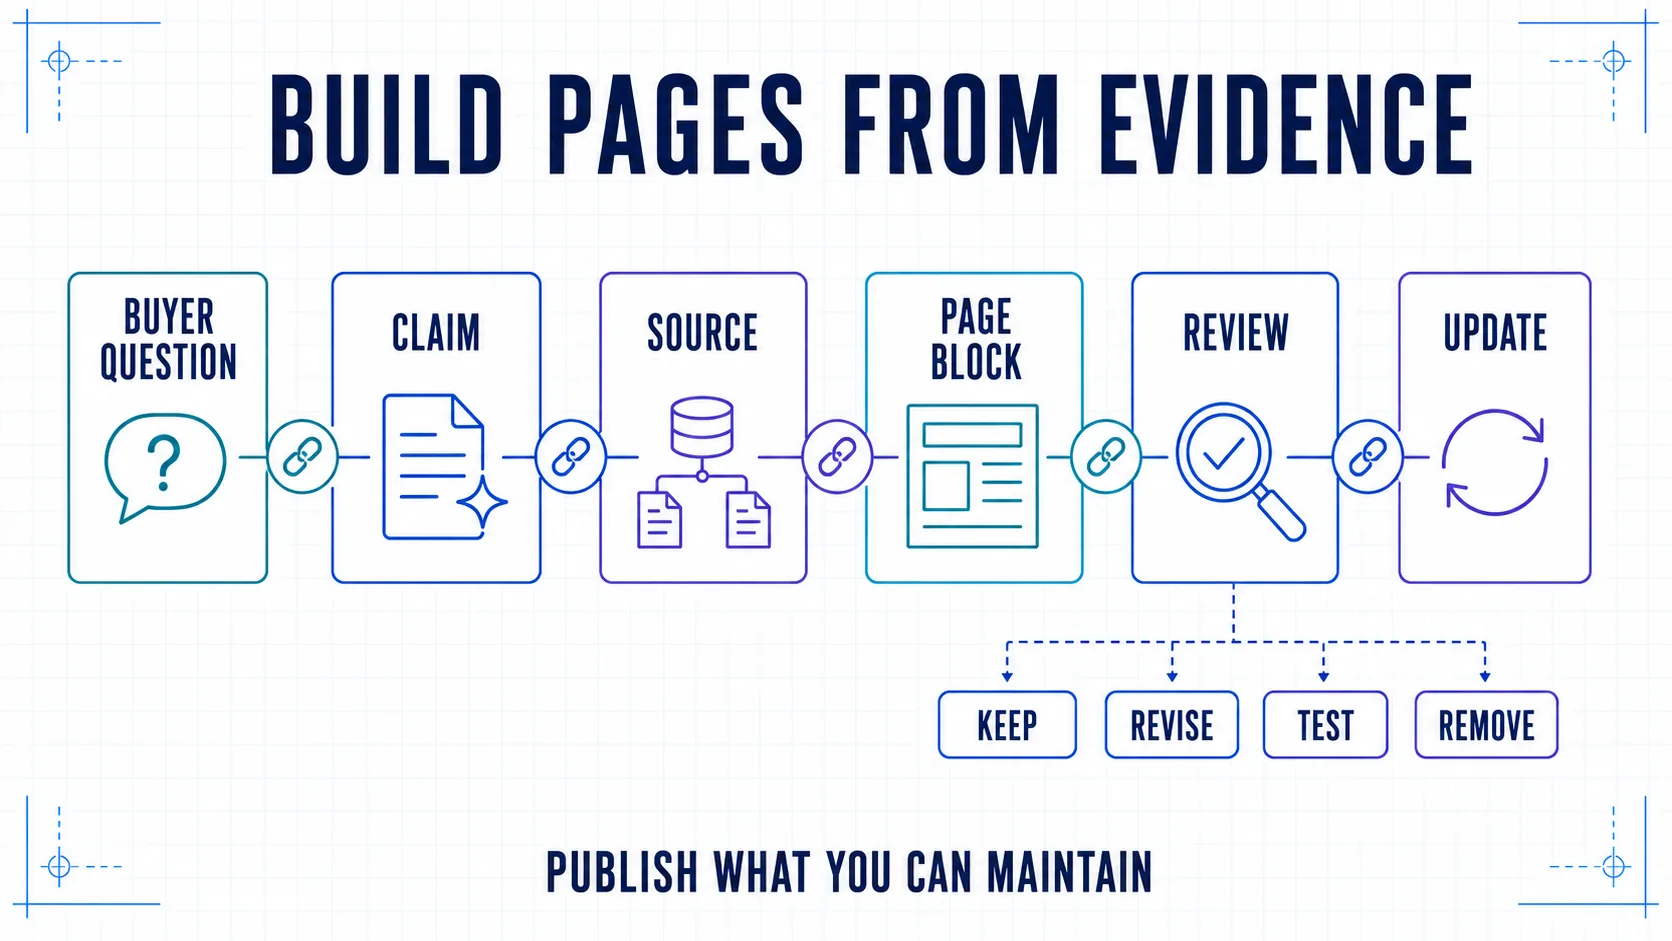
Checkliste für das Seitendesign
- [ ] Beantworten Sie die Hauptfrage nahe am Anfang.
- [ ] Verwenden Sie beschreibende Überschriften entlang der Leseraufgaben.
- [ ] Schreiben Sie vollständige Passagen, deren Aussage samt Einschränkungen auch im Zitat erhalten bleibt.
- [ ] Nutzen Sie nummerierte Schritte für Abläufe und Tabellen für echte Vergleiche.
- [ ] Definieren Sie wichtige Begriffe in klarer Sprache.
- [ ] Erklären Sie Kompromisse, Grenzen, Voraussetzungen und ungeeignete Fälle.
- [ ] Beantworten Sie logische Anschlussfragen, ohne die Intention einer anderen Seite zu übernehmen.
- [ ] Bieten Sie einen sinnvollen nächsten Schritt statt wiederholter Sales-CTAs.
- [ ] Nutzen Sie hilfreiche Bilder mit beschreibendem Alt-Text und Erklärung.
- [ ] Vermeiden Sie Füllwortzahlen, mechanisches „Chunking“ und massenhaft nahezu identische Seiten.
Checkliste für Aussagen und Quellen
- [ ] Ordnen Sie folgenreiche Aussagen primären oder autoritativen Quellen zu.
- [ ] Platzieren Sie Quellen neben der unterstützten Formulierung.
- [ ] Prüfen Sie Geltungsbereich, Datum, Grundgesamtheit und kausale Sprache.
- [ ] Kennzeichnen Sie Beobachtungen, Modelle, Schätzungen und Meinungen.
- [ ] Veröffentlichen Sie Methoden und Grenzen eigener Benchmarks, Umfragen und Tests.
- [ ] Entfernen oder begrenzen Sie nicht pflegbare Aussagen.
- [ ] Erfassen Sie Prüfdaten und überwachen Sie wesentliche Änderungen oder defekte Links.
- [ ] Bieten Sie einen Korrekturweg und benennen Sie den Update-Owner.
- [ ] Ändern Sie
updatedDatenur nach substanzieller Prüfung.
Googles Leitfaden für Inhalte mit generativer KI stellt Genauigkeit, Qualität und Relevanz in den Mittelpunkt. Automatisierung kann Recherche, Transformation, QA oder Entwürfe unterstützen; skalierter Inhalt ohne Mehrwert bleibt jedoch inhaltsarm. Wo Leser Kontext über Automatisierung vernünftigerweise benötigen, erklären Sie das Verfahren.
Eigene Informationen ergänzen
Priorisierte Themencluster brauchen mindestens ein Asset, das sich nicht durch Umschreiben derselben Quellen reproduzieren lässt:
- dokumentierte Implementierung oder Teardown;
- Benchmark mit reproduzierbarer Methode;
- Rechner, Fieldbook, Vorlage oder Entscheidungsframework;
- eigene Umfrage oder anonymisierter Betriebsdatensatz;
- Case mit Baseline, Änderungen, Zeitraum und Grenzen;
- Expertenantworten mit echten Zwängen und Abwägungen.
Nutzen Sie den Leitfaden für quellenbasierte Zitate, um Claim-Register und Review-Regeln aufzubauen.
Gate 4 ist bestanden, wenn: ein skeptischer Redakteur wesentliche Aussagen zur Evidenz zurückverfolgen, Grenzen verstehen und den eigenen Beitrag der Seite erkennen kann.
Gate 5: Entitäten, strukturierte Daten und kommerzielle Oberflächen abgleichen
Strukturierte Daten beschreiben sichtbare Entitäten und können geeignete Search-Darstellungen unterstützen; sie sind kein Zitierschalter. Googles Richtlinien für strukturierte Daten verlangen eine Abbildung sichtbarer, aktueller Seiteninhalte und garantieren kein Rich Result.
Entitätskonsistenz
- [ ] Pflegen Sie einen kanonischen Organisationseintrag mit Name, URL, Logo, Kontakten, Märkten und Kennungen.
- [ ] Erstellen Sie stabile Datensätze für Autoren, Produkte, Leistungen, Angebote und Standorte.
- [ ] Nutzen Sie konsistente Namen und URLs in Navigation, Artikeln, Profilen, Listings und Partnerseiten.
- [ ] Verknüpfen Sie Autoren mit realen Biografien, passender Erfahrung und Review-Verantwortung.
- [ ] Unterscheiden Sie juristische Identität, Geschäftsname, Marke und Produktname.
- [ ] Lösen Sie Konflikte über den Owner der Quelle, nicht durch isolierte Oberflächenkorrektur.
Strukturierte Daten
- [ ] Wählen Sie nur relevante Typen, die Schema.org und die gewünschte Search-Funktion unterstützen.
- [ ] Erzeugen Sie JSON-LD aus denselben Datensätzen wie den sichtbaren Inhalt.
- [ ] Verwenden Sie bei wiederkehrenden Entitäten stabile
@id-Werte. - [ ] Lassen Sie Autoren, Daten, Breadcrumbs, Produkte, Angebote, Ratings, Verfügbarkeit und Richtlinien mit dem Sichtbaren übereinstimmen.
- [ ] Erfinden Sie keine Bewertungen, aggregierten Ratings, Preise, Auszeichnungen, Verfügbarkeiten oder Qualifikationen.
- [ ] Entfernen Sie doppelte oder widersprüchliche Template- und Plugin-Ausgaben.
- [ ] Validieren Sie Syntax, Feature-Eignung und gerenderte Produktionsausgabe.
- [ ] Revalidieren Sie nach Änderungen an Template, CMS, Preis, Lokalisierung oder Routing.
Parität für Ecommerce, Local und Feeds
- [ ] Preis, Währung, Verfügbarkeit, Kennung, Variante und Versand stimmen auf Seite, im Markup, Checkout und Feed überein.
- [ ] Lokaler Name, Adresse, Telefon, Öffnungszeiten, Servicegebiet und Buchungsregeln stimmen auf Website und gepflegten Profilen überein.
- [ ] Richtlinien haben stabile öffentliche URLs und ausdrückliche Gültigkeitsdaten.
- [ ] Schnell veränderliche Werte haben Aktualisierungsverantwortung und möglichst automatische Konfliktprüfungen.
Gate 5 ist bestanden, wenn: der Vergleich von sichtbarem Text, JSON-LD, Feeds und Entitätsdatensätzen keinen wesentlichen Widerspruch findet.
Gate 6: Ein nutzbares, resilientes Erlebnis entwickeln
Performance garantiert keine KI-Zitate. Sie unterstützt Crawling-Effizienz, Vertrauen, Aufgabenerfüllung und Search Page Experience.
Performance und Stabilität
- [ ] Messen Sie Feldwerte für LCP, INP und CLS am 75. Perzentil repräsentativer Seitengruppen.
- [ ] Nutzen Sie Googles „gute“ Schwellen als Release-Ziel: LCP höchstens 2,5 Sekunden, INP höchstens 200 Millisekunden und CLS höchstens 0,1.
- [ ] Verbessern Sie die Serverantwort und entfernen Sie vermeidbare API-Wasserfälle.
- [ ] Identifizieren und priorisieren Sie die reale LCP-Ressource.
- [ ] Reduzieren Sie lange Main-Thread-Aufgaben und unnötige Hydration.
- [ ] Reservieren Sie Abmessungen für Bilder, Embeds, Banner, Anzeigen und Consent-UI.
- [ ] Definieren Sie Route-Budgets für JavaScript, Bilder, Fonts und Drittcode.
- [ ] Testen Sie repräsentative Mobilgeräte und Netze.
Der Core-Web-Vitals-Leitfaden beschreibt den Weg von Felddaten zur Korrektur. Googles Core-Web-Vitals-Dokumentation bleibt die Primärquelle für aktuelle Definitionen und Schwellenwerte.
Barrierefreiheit, Sicherheit und Aufgabenerfüllung
- [ ] Semantische Bereiche und Überschriftenfolge bilden die Dokumentstruktur ab.
- [ ] Tastaturnutzer können navigieren und Hauptaufgaben abschließen.
- [ ] Bilder haben passende Alt-Texte; dekorative Assets werden ignoriert.
- [ ] Formulare bieten Labels, verständliche Fehler und Bestätigungszustände.
- [ ] Kontrast, sichtbarer Fokus, Zoom und Reduced Motion werden berücksichtigt.
- [ ] Consent- und Werbe-Overlays verdecken die Hauptantwort nicht.
- [ ] HTTPS, Security Header, Dependency Review und Abuse Controls gehören zur Release-QA.
- [ ] Rate Limiting schützt die Infrastruktur, ohne freigegebene Crawler oder Kunden still zu blockieren.
- [ ] Wichtige Informationen bleiben bei Ausfall optionaler Skripte nutzbar.
Internationale Auslieferung
- [ ] Jede Locale hat eine stabile URL und einen selbstreferenzierenden Canonical.
- [ ] Äquivalente Seiten verwenden gültige reziproke
hreflang-Angaben. - [ ] Der Sprachwechsel nutzt crawlbare Links.
- [ ] IP- oder Browserspracherkennung erzwingt keinen nicht crawlbaren Redirect.
- [ ] Hauptinhalt, Terminologie, Währungen, Einheiten, Beispiele, Quellen und Nachweise werden wirklich lokalisiert.
- [ ] Fakten und Einschränkungen bleiben sprachübergreifend konsistent.
- [ ] Locale-Routing, Sitemap, Content-Verfügbarkeit und Analytics verwenden ein gemeinsames Register.
- [ ] Muttersprachliche Prompt-Kohorten werden separat gemessen.
Gate 6 ist bestanden, wenn: die priorisierte Aufgabe auf repräsentativen Geräten, in Sprachen und Fehlerzuständen funktioniert, ohne Hauptinformationen zu verlieren.
Gate 7: Launch und Lernschleife instrumentieren
Erstellen Sie die Baseline vor dem Release. Andernfalls wird die Veränderung danach zur Geschichte statt zur Messung.
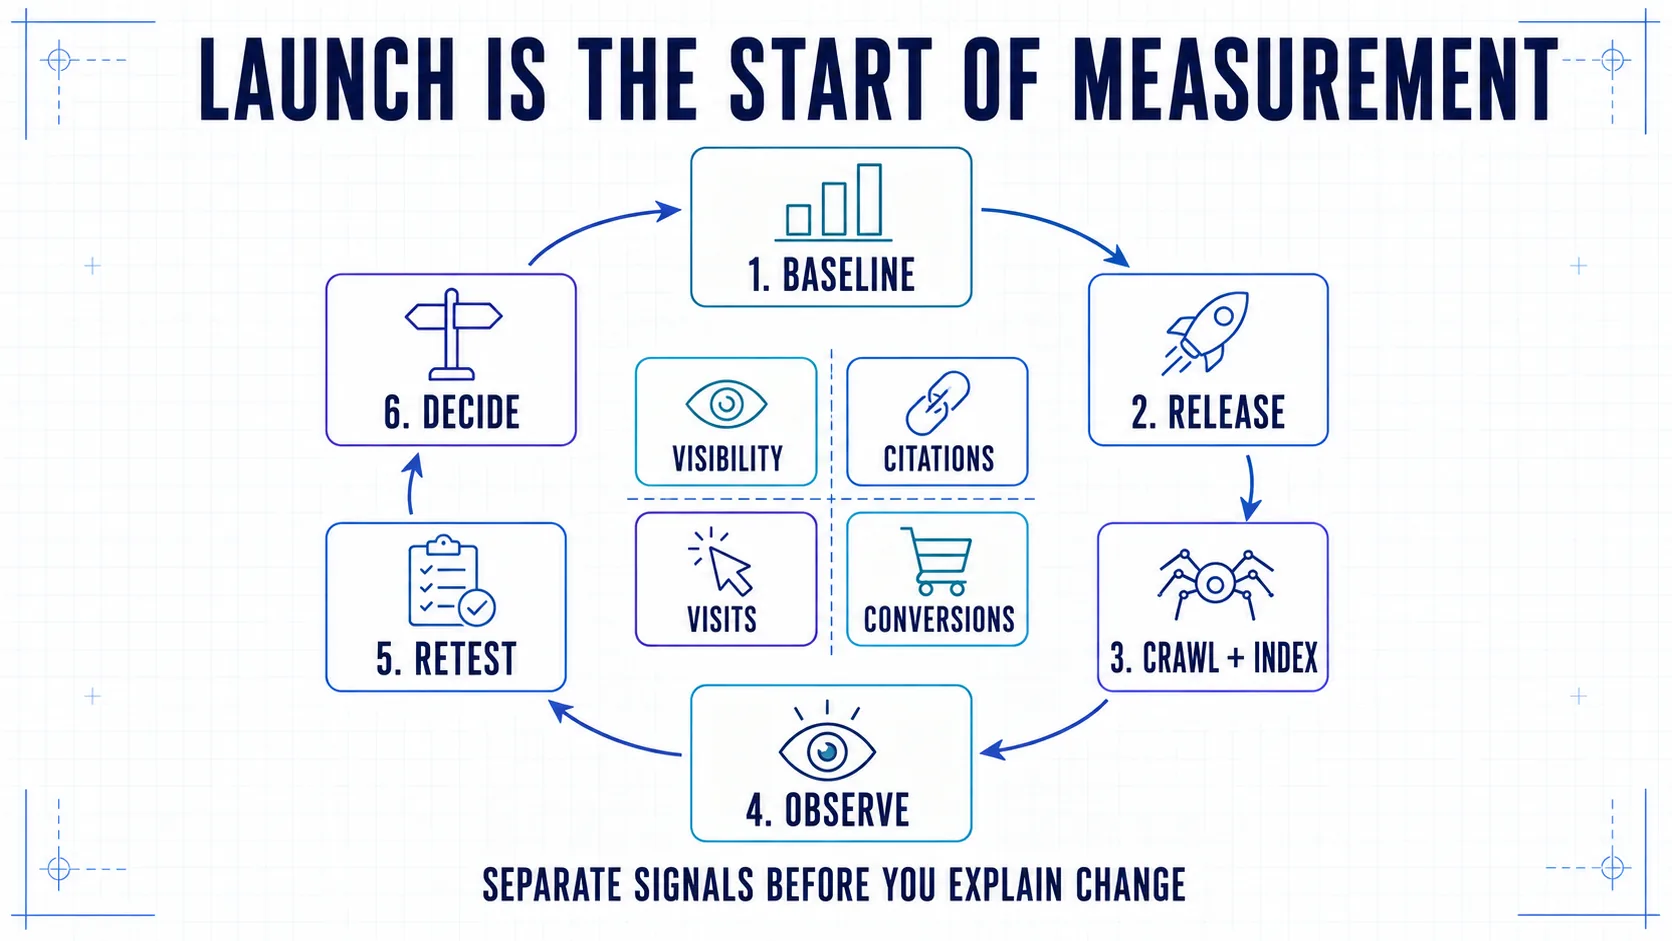
Baseline und Analytics
- [ ] Speichern Sie Baselines für organische Landingpages, Queries, Geräte, Länder, Engagement und Conversions.
- [ ] Exportieren Sie Googles Bericht zur generativen KI-Performance, wenn Daten vorliegen.
- [ ] Trennen Sie Google-Impressions aus AI Overviews und AI Mode von plattformübergreifenden Zitaten.
- [ ] Klassifizieren Sie bekannte KI-Referrals und erhalten Sie Referrer sowie UTM-Parameter über Redirects.
- [ ] Prüfen Sie primäre Conversion-Events in Produktion.
- [ ] Verbinden Sie bei passender Einwilligung qualifizierte Leads, Pipeline oder Umsatz.
- [ ] Fixieren Sie eine Prompt-Kohorte mit Wortlaut, Markt, Sprache, Plattform oder Modus, Session-Zustand, Wiederholung und Erfassungsdatum.
- [ ] Erfassen Sie Erwähnung, eigenes Zitat, zitierte Dritte, Prominenz, Genauigkeit, Sentiment, Besuche und Conversions separat.
- [ ] Führen Sie ein Release-Log mit URLs, Hypothese, Owner und Rollout-Datum.
Googles Bericht zur generativen KI-Performance zeigt derzeit Impressions aus AI Overviews und AI Mode nach Seite, Land, Datum und Gerät. Er liefert Primärnachweise für Google Search, erklärt aber nicht die Auswahl einer Seite und misst weder ChatGPT noch Perplexity.
QA vor dem Launch
- [ ] Crawlen Sie produktionsnahe Ausgabe über alle priorisierten Templates und Locales.
- [ ] Vergleichen Sie Raw HTML, gerendertes HTML und sichtbare Seite.
- [ ] Validieren Sie Statuscodes, Redirects, Canonicals, Robots-Regeln, Sitemaps, Titel, Überschriften, Autoren, Daten und strukturierte Daten.
- [ ] Testen Sie freigegebene Crawler-Pfade durch reales CDN und WAF.
- [ ] Prüfen Sie interne Links, Quellen, Bilder und Download-Assets.
- [ ] Verifizieren Sie Analytics-Events, Consent-Verhalten und Referrer-Erhalt.
- [ ] Testen Sie Performance, Barrierefreiheit, Mobile, Sicherheit und Formulare.
- [ ] Bestätigen Sie Monitoring, Rollback und Incident-Verantwortung.
- [ ] Lassen Sie folgenreiche Aussagen und veröffentlichte Übersetzungen von verantwortlichen Menschen prüfen.
Rhythmus nach dem Launch
- Erfolgreiche Auslieferung und Rendering durch Tests und Logs bestätigen.
- Indexierung und Canonical-Auswahl prüfen.
- Das erste vollständige Beobachtungsfenster markieren.
- Search-Sichtbarkeit, Beobachtungen in generierten Antworten, Besuche und Conversions getrennt vergleichen.
- Sachfehler und Quellenlücken untersuchen, bevor Volumen gejagt wird.
- Nach Möglichkeit nur ein definiertes Content- oder Technikexperiment gleichzeitig durchführen.
- Crawling, Indexierung und ein vertretbares Beobachtungsfenster abwarten.
- Dieselbe Messkohorte erneut ausführen.
- Skalieren, überarbeiten, beibehalten oder stoppen.
Gate 7 ist bestanden, wenn: das Team die Baseline reproduzieren, den genauen Release bestimmen, das Business-Event validieren und den nächsten Vergleich erklären kann.
Implementierungs-Artifact: Laden Sie die AI-Optimized Website Build Spec (Markdown) herunter, um Gates zuzuweisen, Nachweise zu dokumentieren, Claim- und Entity-Register zu führen und Launch sowie 30/60/90-Tage-Reviews in einem Arbeitsdokument abzuwickeln.
Finale Freigabe: Was am Launch-Tag wahr sein muss
Die Website ist launchbereit, wenn:
- jede priorisierte Käuferfrage ein kanonisches, erreichbares Ziel hat;
- wichtige Inhalte in verlässlichem HTML stehen und kein freigegebener Pfad durch Edge-Sicherheit konterkariert wird;
- Aussagen, Autoren, Daten, Produkte, Leistungen und Richtlinien verantwortliche Quellen haben;
- sichtbare Fakten, strukturierte Daten und Feeds übereinstimmen;
- Hauptaufgaben unter repräsentativen Mobil-, Sprach-, Accessibility- und Consent-Bedingungen funktionieren;
- jeder wesentliche Befund Evidenz, Owner und Retest hat;
- Baseline, Release-Marker, Monitoring, Conversion-Test und Rollback-Plan existieren.
Das Bestehen dieser Checkliste garantiert weder Ranking, Erwähnung, Empfehlung, Zitat, Klick noch Umsatz in einem Drittsystem. Es schafft etwas Kontrollierbareres: eine verlässliche öffentliche Quelle, die Menschen nutzen, Suchsysteme abrufen, Redaktionen verteidigen und Unternehmen evidenzbasiert verbessern können.
Für eine bestehende Website nutzen Sie die GEO-Audit-Checkliste, um aktuelle Eignung und Sichtbarkeit zu untersuchen. AppWebSeos Service für Generative Engine Optimization verbindet Architektur, Engineering, Content, Entitäten und Messung zu einem verantwortlichen Implementierungsprogramm.
Primärquellen
- Google: Optimierung für generative KI-Funktionen
- Google: Inhalte mit generativer KI auf Websites
- Google: Grundlagen für JavaScript SEO
- Google: Allgemeine Richtlinien für strukturierte Daten
- Google: Core Web Vitals und Search
- Google Search Console: Bericht zur generativen KI-Performance
- OpenAI: Übersicht der OpenAI-Crawler
- Perplexity: Crawler-Dokumentation
- Der `llms.txt`-Vorschlag