Was ist Schema.org JSON-LD?
Schema.org JSON-LD ist eine maschinenlesbare Beschreibung der Entitäten, Fakten und Beziehungen, die eine Webseite bereits darstellt. Das Vokabular stammt von Schema.org, JSON-LD ist das Serialisierungsformat und Suchmaschinen entscheiden, welche Kombinationen sie für bestimmte Funktionen unterstützen.
Auf einer Webseite steht JSON-LD normalerweise in einem Element vom Typ <script type="application/ld+json">. Google unterstützt JSON-LD, Microdata und RDFa, empfiehlt im Allgemeinen jedoch JSON-LD, weil es sich unabhängig von der sichtbaren HTML-Struktur warten lässt. Diese Bequemlichkeit macht es nicht zu einer zweiten, unsichtbaren Version der Seite. Googles allgemeine Richtlinien für strukturierte Daten verlangen, dass das Markup den sichtbaren Hauptinhalt korrekt beschreibt.
Die kürzeste nützliche Definition lautet:
JSON-LD ist eine typisierte, maschinenlesbare Projektion gepflegter Seitendaten—kein Ort für Behauptungen, die Nutzer nicht überprüfen können.
Es kann geeigneten Seiten die Teilnahme an unterstützten Suchfunktionen ermöglichen und Beziehungen wie Artikel → Autor → Herausgeber explizit machen. Es garantiert kein Rich Result, besseres Ranking, Knowledge Panel oder Zitat in einer KI-Antwort. Google erklärt außerdem, dass für AI Overviews oder AI Mode kein besonderes Schema erforderlich ist; die normalen Voraussetzungen und Qualitätsgrundlagen der Suche gelten weiterhin, wie der Leitfaden für KI-Funktionen festhält.
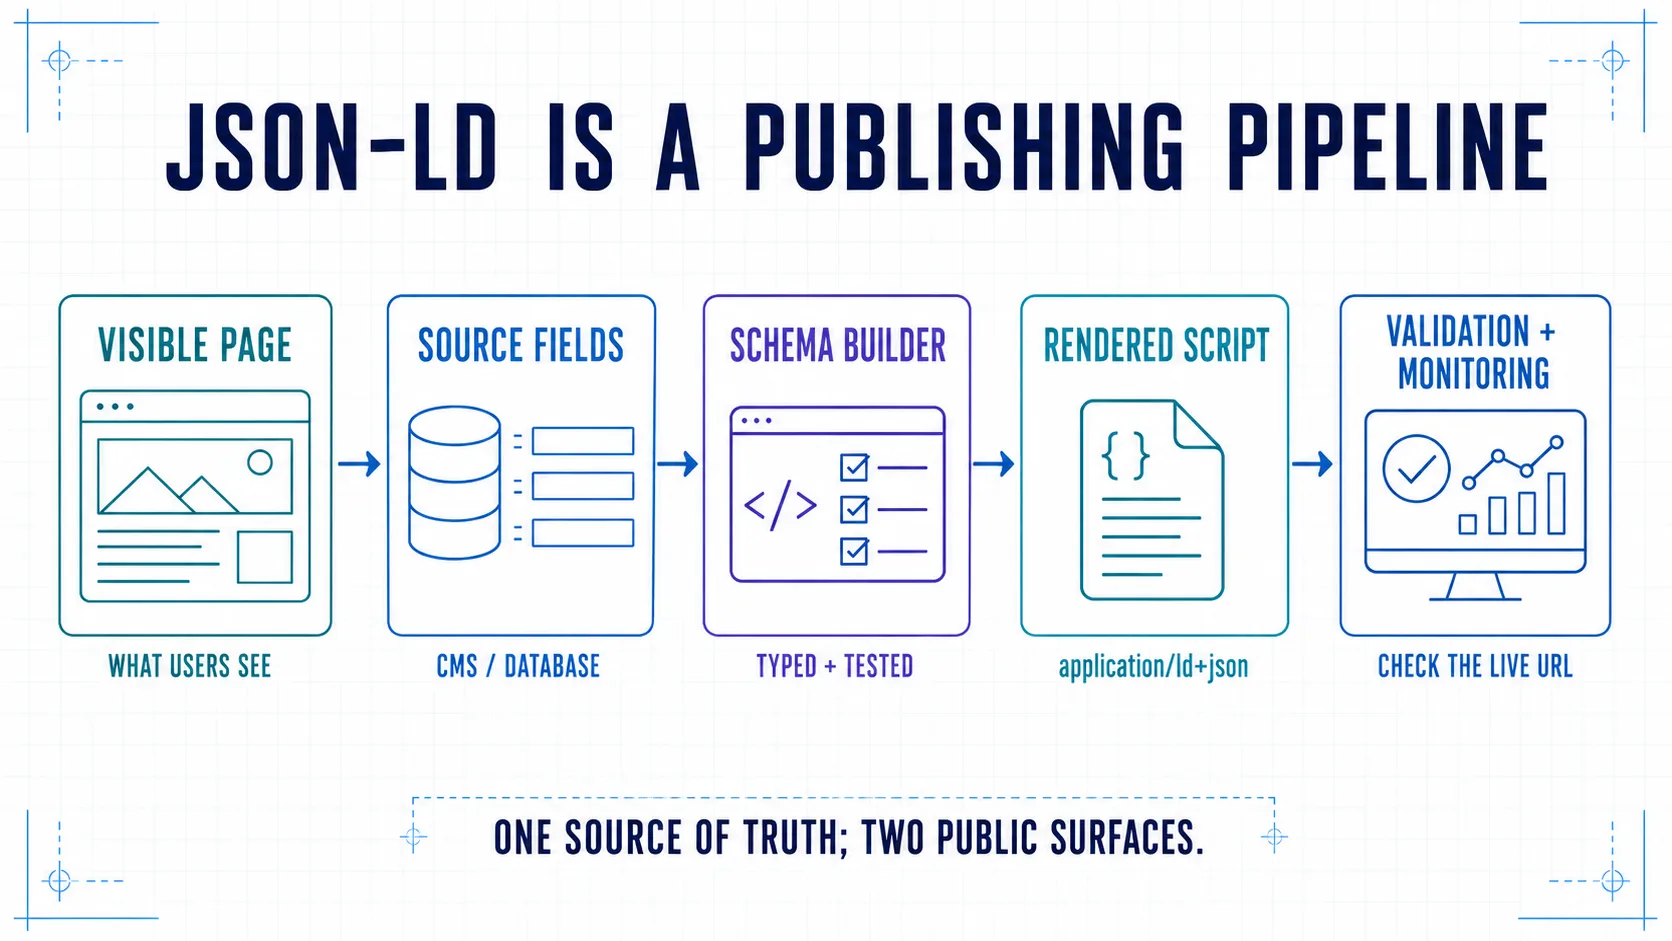
Der Produktionsprozess im Überblick
- Seitenzweck, Ziel und Owner festlegen.
- Einen Schema.org-Typ wählen, der zur realen Seite passt.
- Einen Vertrag für sichtbare Fakten und Quellfelder erstellen.
- Stabile Identifikatoren und Entitätsbeziehungen definieren.
- Den kleinsten korrekten JSON-LD-Graphen bauen.
- Daten sicher serialisieren und einbetten.
- Sicherstellen, dass das Skript auf der fertig gerenderten Seite vorhanden ist.
- Syntax, Vokabular, Feature-Eignung und Inhaltsparität validieren.
- Mit automatisierten Checks ausrollen und Drift überwachen.
Die meisten Fehler entstehen vor der ersten geschweiften Klammer. Ein Team kopiert ein Snippet, füllt Lücken mit plausiblen Werten und betrachtet die Aufgabe als erledigt, sobald ein Validator grün wird. Eine produktionsreife Implementierung dreht die Reihenfolge um: zuerst den Datenvertrag festlegen, dann das Markup aus maßgeblichen Feldern erzeugen und nach jeder Template-Änderung die Live-Ausgabe testen.
Schritt 0: Ziel und Verantwortung definieren
Dokumentieren Sie drei Entscheidungen, bevor Sie einen Typ wählen:
| Entscheidung | Beispiel | Warum sie wichtig ist |
|---|---|---|
| Seitenzweck | Kanonischer redaktioneller Leitfaden | Identifiziert die Hauptentität |
| Beabsichtigte Nutzung | Korrekte Beschreibung plus Article-Eignung | Trennt Modellierung von Darstellungsversprechen |
| Owner | Redaktionelles Plattformteam | Weist Updates und Fehler einem verantwortlichen Team zu |
Beschreiben Sie in einem Satz, worum es auf der Seite hauptsächlich geht: „Dies ist ein redaktioneller Leitfaden von AppWebSeo“, „Dies ist die kanonische Produktseite für ein Abo“ oder „Diese Seite repräsentiert eine Filiale in Wien“. Bleibt dieser Satz unklar, bleibt auch das Schema-Design unklar.
Inventarisieren Sie außerdem jede Stelle, die Markup injizieren kann. Theme, SEO-Plugin, Shop-App, Tag Manager, CMS-Komponente und eigenes Frontend können gleichzeitig strukturierte Daten ausgeben. Legen Sie für jeden Knotentyp genau einen Owner fest. Mehrere gültige Blöcke sind erlaubt; widersprüchliche Organization-, Product- oder Breadcrumb-Knoten erzeugen jedoch unnötige Mehrdeutigkeit.
Schritt 1: Typ von der Seite ableiten und aktuelle Unterstützung prüfen
Nutzen Sie zwei getrennte Referenzen:
- Schema.org definiert Typen, Properties und Beziehungen.
- Googles Search Gallery dokumentiert, welche strukturierten Datentypen Google derzeit für Suchfunktionen nutzt, und verlinkt die funktionsspezifischen Regeln.
Ein gültiges Vokabular und die Unterstützung durch Google sind nicht dasselbe. Ein Service-Knoten kann korrektes Schema.org sein, ohne ein besonderes Google-Ergebnis auszulösen. Umgekehrt kann ein unterstützter Product-Typ ungeeignet bleiben, wenn Seite, Properties, Angebot oder Richtlinien nicht passen.
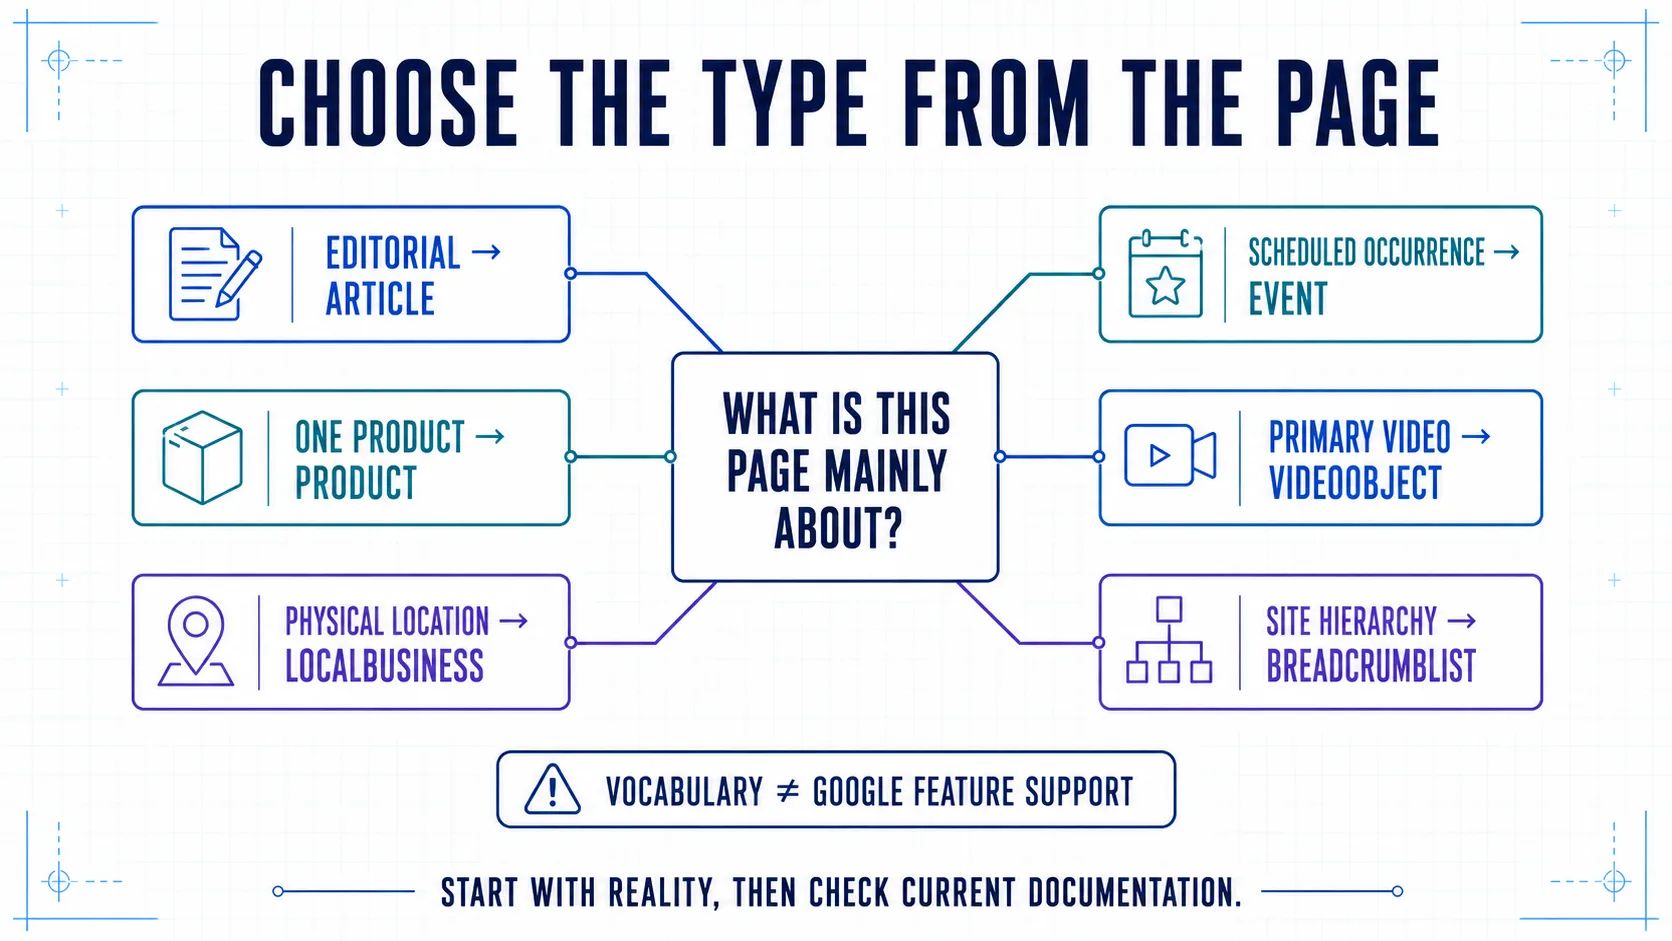
Praktische Typzuordnung für 2026
| Seitenzweck | Typischer Typ | Vor dem Release prüfen |
|---|---|---|
| Redaktioneller Beitrag oder Guide | Article, BlogPosting oder NewsArticle | Aktuelle Article-Dokumentation, wahrheitsgemäße Daten und Byline |
| Ein Produkt oder Angebot | Product plus Offer, wenn vorhanden | Product Snippets vs. Merchant Listings, Preis- und Bestandsparität |
| Physischer Standort | Passender LocalBusiness-Untertyp | Echter Name, Adresse, Öffnungszeiten, Telefon und Richtlinien |
| Terminierter Vorgang | Event | Reales Datum, Ort oder Online-Teilnahme sowie Status |
| Seite mit einem Video als Hauptinhalt | VideoObject | Crawlbares Vorschaubild und zugängliches Video |
| Navigationshierarchie | BreadcrumbList | Tatsächlicher Nutzerpfad und kanonische Item-URLs |
| Website- oder Herausgeberidentität | WebSite, Organization, Person | Stabile Identitätsdaten; Validität allein verspricht kein Feature |
Verwenden Sie kein altes Tutorial als Support-Matrix. Google stellte HowTo Rich Results 2023 ein und beendete die Darstellung von FAQ Rich Results im Mai 2026, wie das Update-Protokoll der Search-Dokumentation festhält. HowTo und FAQPage können weiterhin im Schema.org-Vokabular existieren, sind deshalb aber keine aktuellen Google-Rich-Result-Taktiken.
Bei Article-Markup gibt es eine weitere Änderung, die starre Checklisten übersehen: In der aktuellen Google-Dokumentation stehen empfohlene Properties statt eines universellen Satzes von Pflichtfeldern. Ergänzen Sie jede zutreffende und korrekte Empfehlung, die der Seite dient. Erfinden Sie keinen Wert, um eine veraltete Liste „erforderlicher Properties“ zu erfüllen.
Schritt 2: Vertrag für sichtbare Fakten erstellen
Dokumentieren Sie für jede geplante Property das maßgebliche Feld, die sichtbare Position, die Transformationsregel und den Owner. Diese Tabelle wird zum Vertrag zwischen Content-, Frontend-, Commerce- und SEO-Team.
| JSON-LD-Property | Maßgebliche Quelle | Sichtbare Oberfläche | Transformation und Test |
|---|---|---|---|
headline | CMS-Titel | H1 | Redaktionellen Wert übernehmen; nur Whitespace normalisieren |
description | CMS-Zusammenfassung | Intro oder Metadaten | Keine abweichende Behauptung erzeugen |
datePublished | Unveränderlicher Publikationszeitpunkt | Datumszeile | Als ISO 8601 ausgeben |
dateModified | Materielles redaktionelles Update | Aktualisierungsdatum | Nicht bei jedem Build ändern |
author | ID aus Autorenverzeichnis | Byline/Profil | Zu einer stabilen @id auflösen |
image | Medien-Datensatz | Hero- oder Artikelbild | Absolute, crawlbare URL und repräsentatives Bild |
mainEntityOfPage | Kanonische Route | Kanonische Seite | Absolute kanonische URL |
offers.price | Commerce-Datensatz | Sichtbares Angebot | Identischer Wert, Währung und aktuelle Verfügbarkeit |
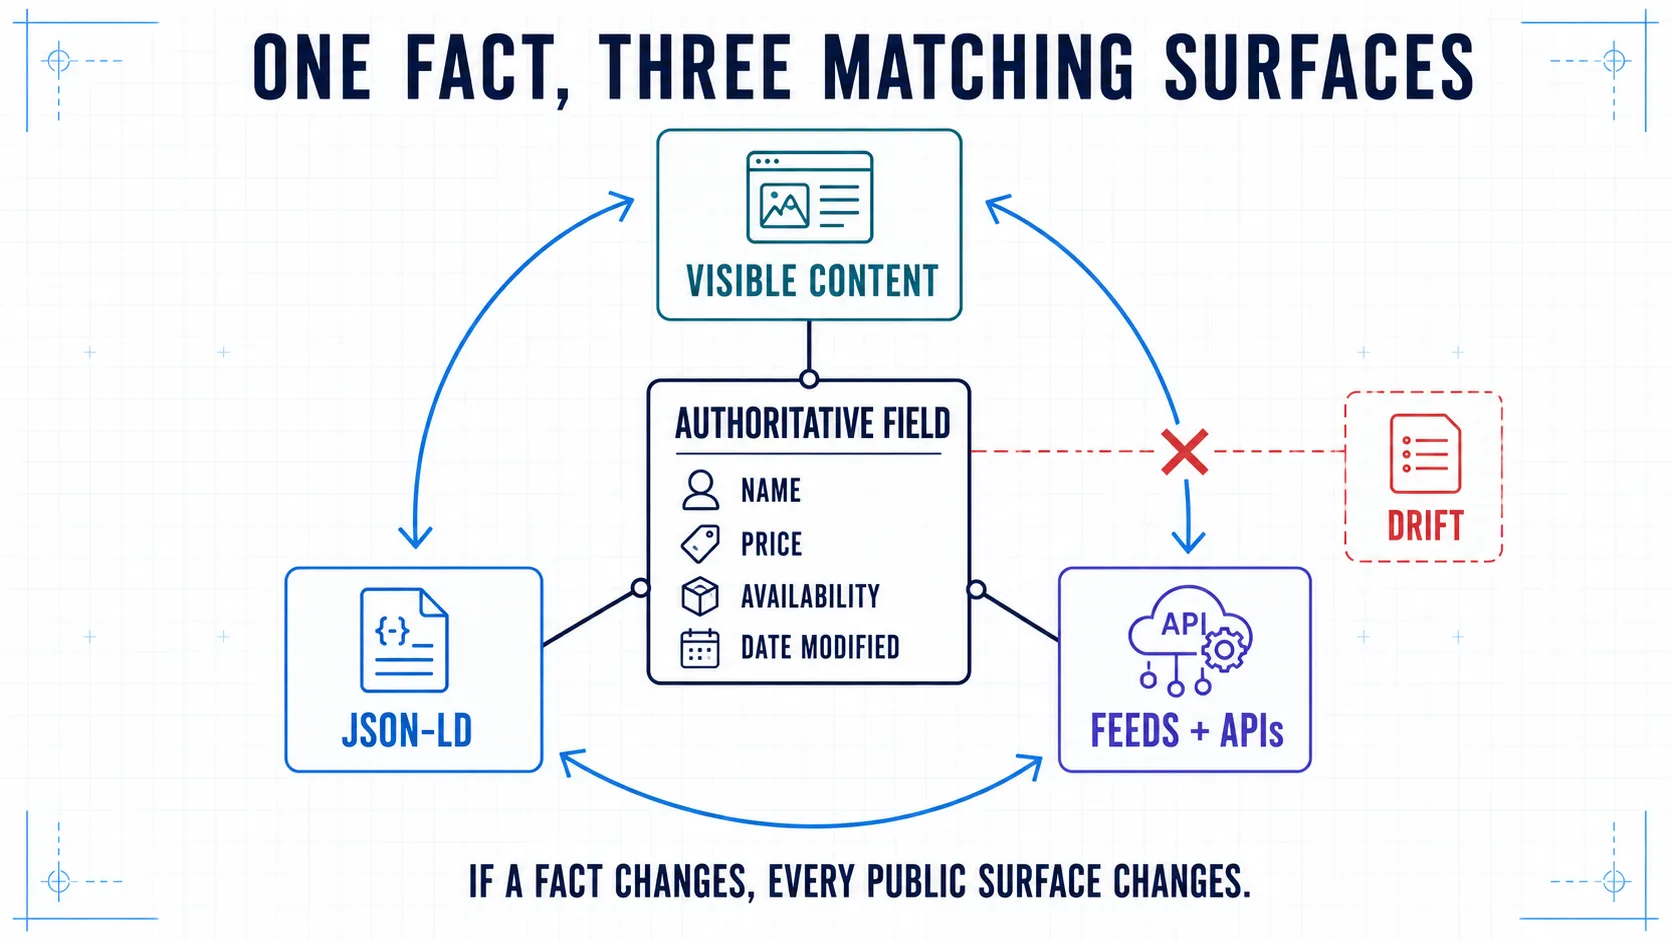
Die Regel lautet: ein Fakt, ein Owner, mehrere generierte Oberflächen. Lassen Sie Redakteure einen Preis nicht in der Produktkomponente und zusätzlich in einem SEO-Plugin eintragen. Berechnen Sie dateModified nicht aus dem Deployment-Zeitpunkt. Veröffentlichen Sie kein AggregateRating, wenn keine echten, zugänglichen Bewertungsdaten und keine passende Plattformrichtlinie dahinterstehen.
Ist ein Wert unsicher, lassen Sie ihn weg, bis seine Quelle belastbar ist. Ein kleiner, korrekter Graph ist besser als eine umfassende Fiktion.
Schritt 3: stabile Entitäts-IDs und Beziehungen entwerfen
Eine @id identifiziert einen Knoten, damit andere Knoten dieselbe Entität referenzieren können, statt ähnliche Duplikate anzulegen. Die Schema.org-Dokumentation zum Datenmodell empfiehlt URIs als Identifikatoren. Eine absolute kanonische URL mit Fragment ist praktikabel:
https://example.com/#organizationhttps://example.com/people/alex#personhttps://example.com/insights/json-ld-guide#articlehttps://example.com/insights/json-ld-guide#webpage
Das Fragment muss nicht als separates Dokument auflösbar sein. Es muss im Publishing-System stabil und eindeutig sein und immer wiederverwendet werden, wenn dieselbe Entität erscheint. Ein Wechsel von #org zu #organization zwischen Templates erzeugt zwei Identifikatoren für denselben Herausgeber. Dieselbe ID für zwei Personen verschmilzt dagegen unterschiedliche Entitäten.
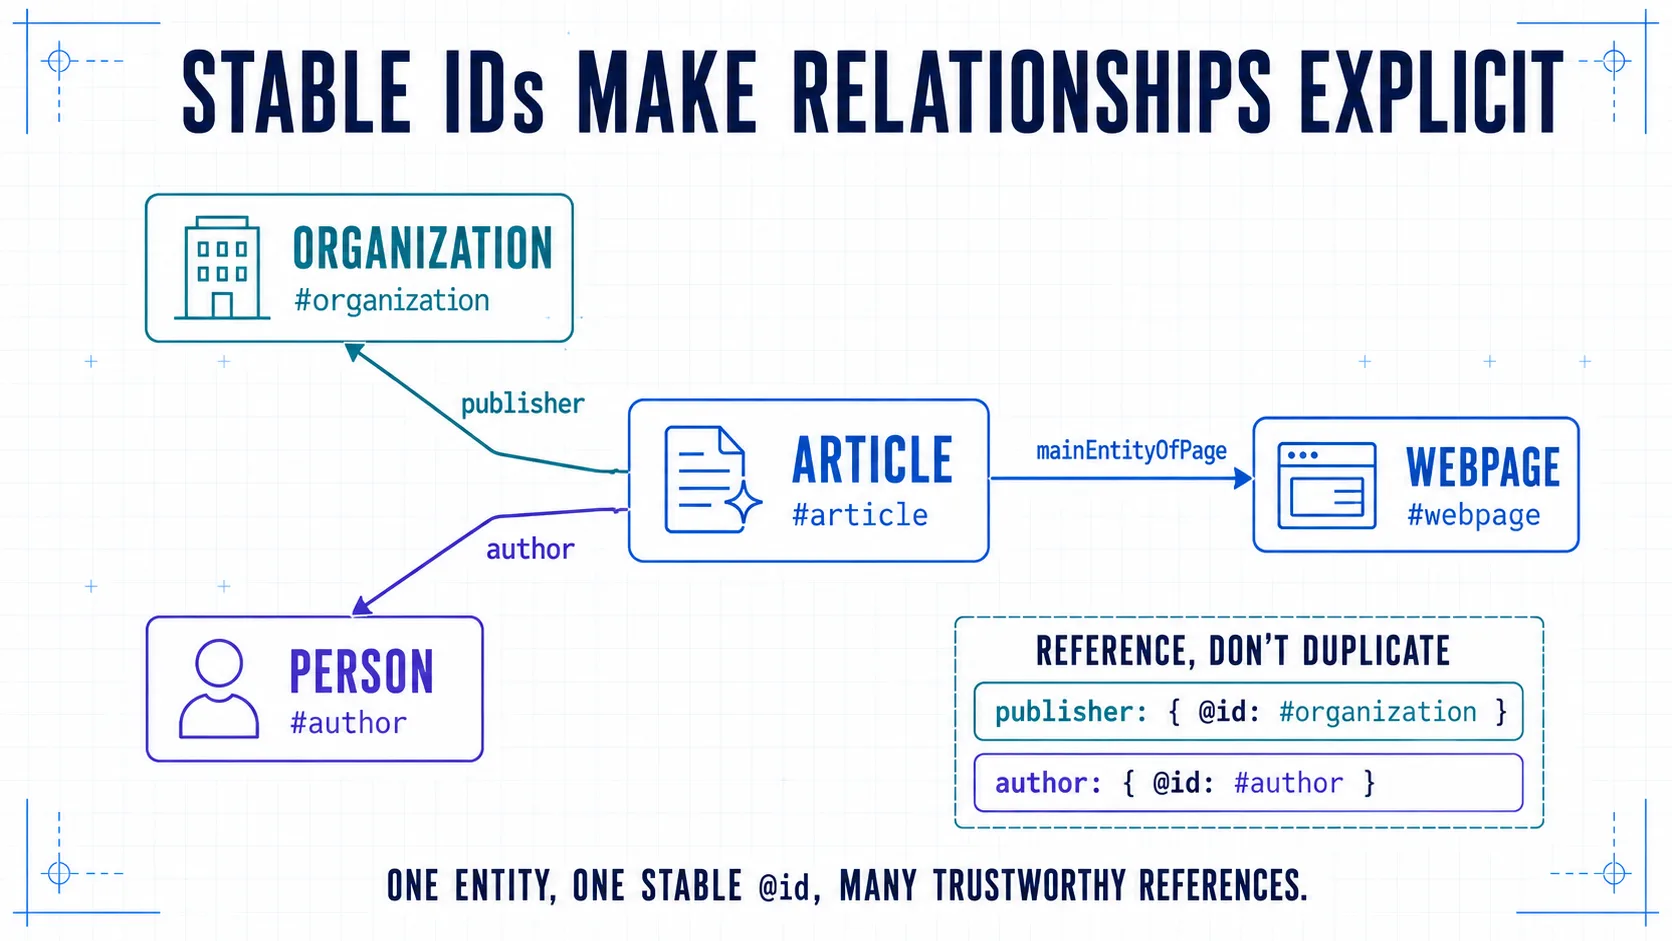
Verwenden Sie @graph, wenn mehrere Top-Level-Knoten gemeinsam beschrieben werden müssen. Es ist ein Organisationswerkzeug, kein Qualitätswert. Die sinnvolle Frage lautet nicht „Wie viele Knoten können wir ergänzen?“, sondern „Welche Entitäten und Beziehungen braucht diese Seite wirklich?“
Schritt 4: den kleinsten korrekten Graphen bauen
Das folgende Beispiel verbindet WebPage, BlogPosting, Person und Organization. Ersetzen Sie jeden Platzhalter durch Werte aus dem tatsächlichen Datenvertrag der Seite.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://example.com/#organization",
      "name": "Example Studio",
      "url": "https://example.com/",
      "logo": {
        "@type": "ImageObject",
        "url": "https://example.com/media/logo.png"
      }
    },
    {
      "@type": "Person",
      "@id": "https://example.com/people/alex#person",
      "name": "Alex Example",
      "url": "https://example.com/people/alex"
    },
    {
      "@type": "WebPage",
      "@id": "https://example.com/insights/json-ld-guide#webpage",
      "url": "https://example.com/insights/json-ld-guide",
      "name": "How to Implement Schema.org JSON-LD"
    },
    {
      "@type": "BlogPosting",
      "@id": "https://example.com/insights/json-ld-guide#article",
      "mainEntityOfPage": {
        "@id": "https://example.com/insights/json-ld-guide#webpage"
      },
      "headline": "How to Implement Schema.org JSON-LD",
      "description": "A production implementation guide.",
      "datePublished": "2026-08-18",
      "dateModified": "2026-09-07",
      "image": [
        "https://example.com/media/json-ld-guide-16x9.jpg",
        "https://example.com/media/json-ld-guide-4x3.jpg",
        "https://example.com/media/json-ld-guide-1x1.jpg"
      ],
      "author": {
        "@id": "https://example.com/people/alex#person"
      },
      "publisher": {
        "@id": "https://example.com/#organization"
      }
    }
  ]
}
</script>
Verwenden Sie absolute kanonische URLs. Nehmen Sie Properties auf, die zutreffen, aktuell sind und von Ihren Daten gestützt werden. Google empfiehlt für Article-Markup repräsentative, crawlbare Bilder und—wenn verfügbar—mehrere hochauflösende Seitenverhältnisse von 16:9, 4:3 und 1:1. Das ist eine Publishing-Anforderung und kein Grund, alle drei Werte auf beliebige Ausschnitte zu setzen.
Entscheiden Sie bei Produktdaten, ob die Seite für Product Snippets, Merchant Listings oder beides geeignet ist. Googles Product-Dokumentation erklärt, dass strukturierte Daten auf der Seite und Merchant-Center-Feeds einander ergänzen. Erzeugen Sie beides aus denselben Commerce-Datensätzen, damit Preis und Verfügbarkeit nicht widersprechen.
Schritt 5: sicher serialisieren—gültiges JSON reicht nicht
Bauen Sie JSON-LD niemals per String-Verkettung. Ein JSON-Serializer behandelt Anführungszeichen, Zeilenumbrüche und andere JSON-Syntax korrekt. Beim Einbetten in HTML kommt jedoch eine zweite Grenze hinzu: der HTML-Parser.
Unerwartete Tatsache: Ein JavaScript-Objekt kann zu vollkommen gültigem JSON serialisiert werden und dennoch unsicher sein, wenn es roh in ein HTML-Script-Element gelangt. Ein Inhaltswert mit </script> kann das Element vorzeitig beenden. Prüfen Sie die Daten und verwenden Sie das sichere Serialisierungsmuster Ihres Frameworks.
Erzeugen Sie für statisches HTML den serialisierten und HTML-sicheren String in vertrauenswürdigem Build-Code, nicht manuell im Template. Die JSON-LD-1.1-Spezifikation beschreibt die Einschränkungen bei der Einbettung in Script-Elemente.
Für Next.js zeigt der offizielle JSON-LD-Leitfaden ein minimales Muster, das < durch seine Unicode-Sequenz ersetzt:
const jsonLd = {
  '@context': 'https://schema.org',
  '@type': 'BlogPosting',
  headline: post.title,
  datePublished: post.publishedAt,
  dateModified: post.updatedAt,
  author: {
    '@type': 'Person',
    name: post.author.name,
  },
};

const serializedJsonLd = JSON.stringify(jsonLd).replace(/</g, '\\u003c');

return (
  <script
    type="application/ld+json"
    dangerouslySetInnerHTML={{ __html: serializedJsonLd }}
  />
);
Nutzen Sie einen von Ihrer Organisation freigegebenen Serializer oder Sanitizer, wenn der Sicherheitsstandard mehr verlangt. Behandeln Sie CMS-Werte als nicht vertrauenswürdige Eingabe, auch wenn nur Redakteure sie eingeben dürfen. Typen wie schema-dts erkennen Strukturfehler während der Entwicklung; TypeScript beweist aber nicht, dass eine Aussage sichtbar, wahr oder nach Suchrichtlinien geeignet ist.
Schritt 6: für Crawler und Validatoren rendern
JSON-LD kann im Head oder Body stehen. In serverseitig gerenderten oder statisch generierten Anwendungen sollte es möglichst bereits im initialen HTML ausgegeben werden. Google kann per JavaScript erzeugte strukturierte Daten verarbeiten. Der Leitfaden für JavaScript-generierte strukturierte Daten empfiehlt jedoch den URL-Test und warnt davor, dass dynamisch erzeugtes Produkt-Markup bei schnell wechselnden Werten weniger zuverlässig sein kann.
Für React- und Headless-Stacks:
- einen typisierten Builder pro Seitenfamilie erstellen, statt Objekte zwischen Routen zu kopieren;
- sichtbaren Inhalt und JSON-LD aus demselben normalisierten Datensatz erzeugen;
- leere optionale Properties weglassen, statt
null,undefinedoder leere Arrays auszugeben; - einen verantworteten Graphen serverseitig oder beim Prerendering ausgeben;
- Response-HTML und gerenderten DOM prüfen;
- Client-Navigation testen, wenn Metadaten zwischen Routen veralten können.
Tag Manager schaffen einen zweiten Publishing-Pfad und duplizieren oft CMS-Werte. Nutzen Sie sie nur in kontrollierten Fällen mit Versionierung und Live-URL-Tests—nicht für schnell wechselnde Preise, Bestände, Daten oder Event-Status.
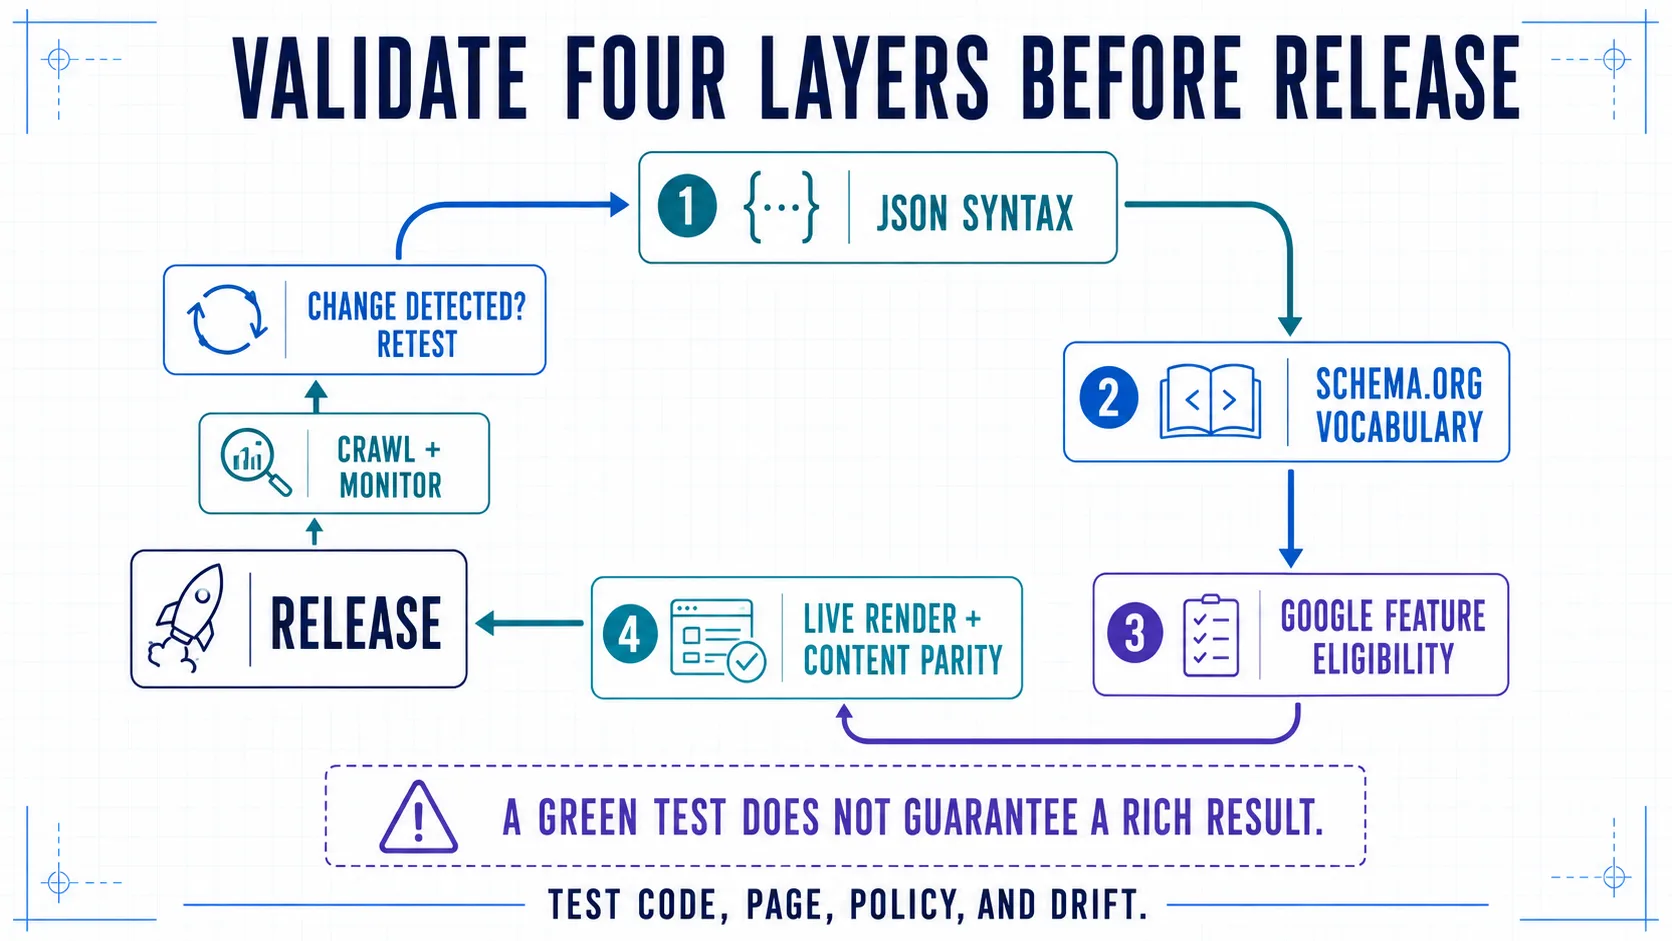
Schritt 7: vier getrennte Ebenen validieren
Ebene 1: JSON-Syntax
Parsen Sie exakt die serialisierte Ausgabe. Der Build sollte bei ungültigem JSON, doppelten Objektschlüsseln in handgeschriebenen Fixtures, nicht absoluten kanonischen URLs, fehlerhaften Datumsangaben oder lokalisierten Zahlenstrings scheitern.
Ebene 2: Schema.org-Vokabular
Prüfen Sie Typen und Properties im Schema Markup Validator. Er findet Probleme im Vokabular. Er entscheidet weder über Google-Unterstützung noch darüber, ob Ihre Seite Googles Richtlinien erfüllt.
Ebene 3: Eignung für Google-Funktionen
Nutzen Sie Googles Rich Results Test für unterstützte Funktionen. Testen Sie während der Entwicklung ein repräsentatives Codebeispiel und vor der Freigabe die ausgerollte URL. Warnungen sollten gelesen, nicht automatisch unterdrückt werden: Manche weisen auf sinnvolle empfohlene Properties hin, andere sind für die konkrete Seite nicht anwendbar.
Ebene 4: Live-Rendering und Inhaltsparität
Rufen Sie die öffentliche URL anonym ab und prüfen Sie ausgeliefertes HTML sowie gerenderten DOM. Bestätigen Sie:
- der erwartete JSON-LD-Block ist genau einmal vorhanden und parsebar;
- kanonische URLs und
mainEntityOfPagestimmen überein; - Überschrift, Autor, Daten, Preis, Bestand und andere kritische Werte entsprechen der Seite;
- Robots-Regeln, Login, WAF oder Consent-Logik verstecken weder Seite noch Assets;
- kein Plugin, Theme oder Tag Manager veröffentlicht einen widersprüchlichen Knoten.
Ein gültiger Knoten kann zu Recht keine Rich-Result-Vorschau erzeugen. Auch ein bestandener Rich Results Test führt nicht zwingend zu einem sichtbaren Rich Result. Eignung ist notwendig, aber kein Darstellungsversprechen.
Schritt 8: automatisierte Release-Checks ergänzen
Testen Sie Builder mit realen Grenzfällen: Anführungszeichen, nicht lateinische Namen, fehlende optionale Bilder, Autoren mit und ohne Profilseite, eingestellte Angebote, verschobene Events und geänderte kanonische Routen.
Prüfen Sie mindestens:
- einen primären Article-, Product-, Event- oder Location-Knoten pro kanonischer Detailseite;
- eine stabile ID für jeden wiederverwendeten Herausgeber, Autor, jedes Produkt und jeden Ort;
- gültige ISO-Daten und absolute öffentliche URLs;
- sichtbare Parität für Preis, Währung, Verfügbarkeit, Titel, Autor und Änderungsdatum;
- keine erfundenen Bewertungen, Rezensionen oder Angebote;
- sichere Serialisierung von
<, Anführungszeichen, Zeilentrennern und schließenden Tags; - Präsenz in der serverseitig gerenderten Ausgabe;
- keine doppelten Knoten aus Plugins und eigenen Templates.
Fügen Sie pro Seitenfamilie eine Routen-Fixture zur CI hinzu und crawlen Sie nach dem Release eine Produktionsstichprobe. Komponententests erkennen keine CDN-Umschreibung, keinen alten CMS-Cache und kein Tag-Manager-Duplikat.
Schritt 9: Drift statt nur Fehler überwachen
Validatoren finden fehlerhafte Strukturen; sie wissen nicht, wann ein ehemals korrekter Wert veraltet ist. Überwachen Sie Parse-Fehler, fehlende Blöcke, neue Warnungen, sichtbare Abweichungen, doppelte IDs, Search-Console-Trends, Änderungen an Googles Feature-Dokumentation und Releases an CMS, Routing, Preisen oder Metadaten-Komponenten.
Versionieren Sie den Graph-Vertrag wie eine API. Eine Feldumbenennung, neue Währung, Autorenmigration oder URL-Überarbeitung sollte betroffene Typen, Fixtures, Owner, Rollout-Reihenfolge und Rollback-Weg benennen. Validieren Sie direkt nach der Änderung erneut—nicht erst, wenn Search Console irgendwann ein Problem meldet.
Implementierungsartefakt: JSON-LD Production Fieldbook herunterladen (Markdown). Es enthält Seiteninventar, Feature-Support-Prüfung, Quellfeldvertrag, @id-Register, Graph-Plan, Serialisierungskontrollen, Validierungsmatrix, CI-Gates, Release-Protokoll und 30/60/90-Tage-Drift-Review.
Hinweise für verschiedene Stacks
Plain HTML oder Static Site Generator
Erzeugen Sie JSON-Objekte im Build-Code, serialisieren Sie einmal und setzen Sie die sichere Ausgabe in das Template ein. Referenzieren Sie globale Organization- und WebSite-Definitionen über stabile IDs. Vermeiden Sie die manuelle Pflege hunderter Snippets.
WordPress oder ein anderes CMS
Inventarisieren Sie Theme- und Plugin-Ausgabe, bevor Sie eigenes Markup ergänzen. Legen Sie fest, wer Organization, Article, Breadcrumb und Product besitzt. Bilden Sie Custom Fields in einem Graphen ab und crawlen Sie die Seite nach jedem Plugin- oder Theme-Update auf Duplikate.
Shopify oder eine andere Ecommerce-Plattform
Erzeugen Sie Product- und Offer-Werte aus demselben Katalogdatensatz, der sichtbare Seite und Feeds speist. Testen Sie Varianten, Sale-Preise, Währungsmärkte, Out-of-stock-Zustände, Bundles und Abos getrennt. Lassen Sie App und Theme keine konkurrierenden Product-Knoten veröffentlichen.
Next.js, React oder Headless-Architektur
Platzieren Sie Schema-Builder bei normalisierten Domain-Modellen statt in UI-Komponenten. Rendern Sie den finalen Block serverseitig oder vorab, nutzen Sie typisierte Fixtures, maskieren Sie die serialisierte Ausgabe sicher und testen Sie Seitenwechsel. Unser Vergleich von Headless React und monolithischem CMS erläutert die größeren Ownership-Abwägungen.
Häufige Implementierungsfehler
Generisches Template unverändert kopieren
Platzhalter, ungeeignete Typen und nicht existente Properties bleiben bestehen, weil das Beispiel „vollständig“ aussah. Beginnen Sie mit dem Datenvertrag, nicht mit der Größe des Templates.
Versteckte oder fremde Informationen auszeichnen
Strukturierte Daten sollten den sichtbaren Hauptinhalt beschreiben. Rezensionen, Angebote, Fragen oder Events gehören nicht ausschließlich in JSON-LD.
Vokabular-Validator mit Suchgarantie verwechseln
Schema.org-Validität, Google-Feature-Eignung, Rendering, Richtlinienkonformität und tatsächliche Darstellung sind fünf verschiedene Fragen.
Mehrere Versionen derselben Entität erzeugen
Ein Plugin verwendet #organization, das Theme #publisher und eine eigene Komponente erstellt eine Organization ohne ID. Konsolidieren Sie Ownership und referenzieren Sie einen stabilen Knoten.
Seite ohne JSON-LD aktualisieren
Veraltete Preise, Daten, Event-Status, Autoreninformationen und Verfügbarkeiten sind Fehler der Datenpipeline. Erzeugen Sie beide Oberflächen aus einer Quelle und überwachen Sie ihre Parität.
Schema als Schalter für KI-Zitate behandeln
Korrekte Beziehungen können Mehrdeutigkeit reduzieren und geeignete Suchfunktionen unterstützen. Keine offizielle Quelle verspricht jedoch, dass JSON-LD ein KI-Zitat erzeugt. Crawlability, Indexierung, nützliche Quellinhalte, Belege, Reputation und Query-Relevanz bleiben eigenständig. Diese Trennung prägt auch unseren evidenzbasierten GEO-Leitfaden und die Checkliste für eine KI-optimierte Website.
Produktionscheckliste
- [ ] Seitenzweck und Hauptentität sind dokumentiert.
- [ ] Der Typ passt zur realen Seite und aktuellen Dokumentation.
- [ ] Jede kritische Property hat eine maßgebliche Quelle und sichtbare Position.
- [ ] IDs sind absolut, stabil, eindeutig und werden konsequent wiederverwendet.
- [ ] Der Graph enthält nur notwendige, wahrheitsgemäße Beziehungen.
- [ ] Die Ausgabe wird sicher serialisiert und eingebettet.
- [ ] Das Skript steht im serverseitig oder zuverlässig gerenderten öffentlichen HTML.
- [ ] Syntax, Vokabular und der relevante Feature-Test enthalten keine ungeklärten Probleme.
- [ ] Live-Werte entsprechen sichtbaren Inhalten; keine doppelten Knoten widersprechen.
- [ ] CI deckt Builder, Grenzfälle, Routen und Serialisierung ab.
- [ ] Ein benannter Owner überwacht Drift und Dokumentationsänderungen.
Fazit
Die beste JSON-LD-Implementierung ist weder der größte Graph noch diejenige mit den meisten grünen Abzeichen. Es ist das kleinste korrekte Modell, das aus gepflegten Quellfeldern entsteht, stabile Identität nutzt, die HTML-Grenze sicher übersteht, auf der Live-Seite vorhanden ist und sich ändert, sobald sich die zugrunde liegenden Fakten ändern.
Bauen Sie dieses System einmal pro Seitenfamilie, wird JSON-LD zur verlässlichen Publishing-Infrastruktur. Kopieren Sie isolierte Snippets in Templates, wird es technische Schuld mit geschweiften Klammern.